
Den agentiske hjernen: fremtidens dataplattform
Neste nivå etter at dere har skapt en dataplattform er AI-agenter som går gjennom hele datagrunnlaget, bygger en intern wiki for virksomheten og holder den oppdatert selv.
Det er lett å lage en AI-agent som imponerer i en demo. Det er langt vanskeligere å lage en agent som en virksomhet trygt kan slippe løs på egne dokumenter og systemer. Her viser vi hvordan vi bygger dem: harnessen og dataene er kjernen, mens modeller og flater kan byttes.

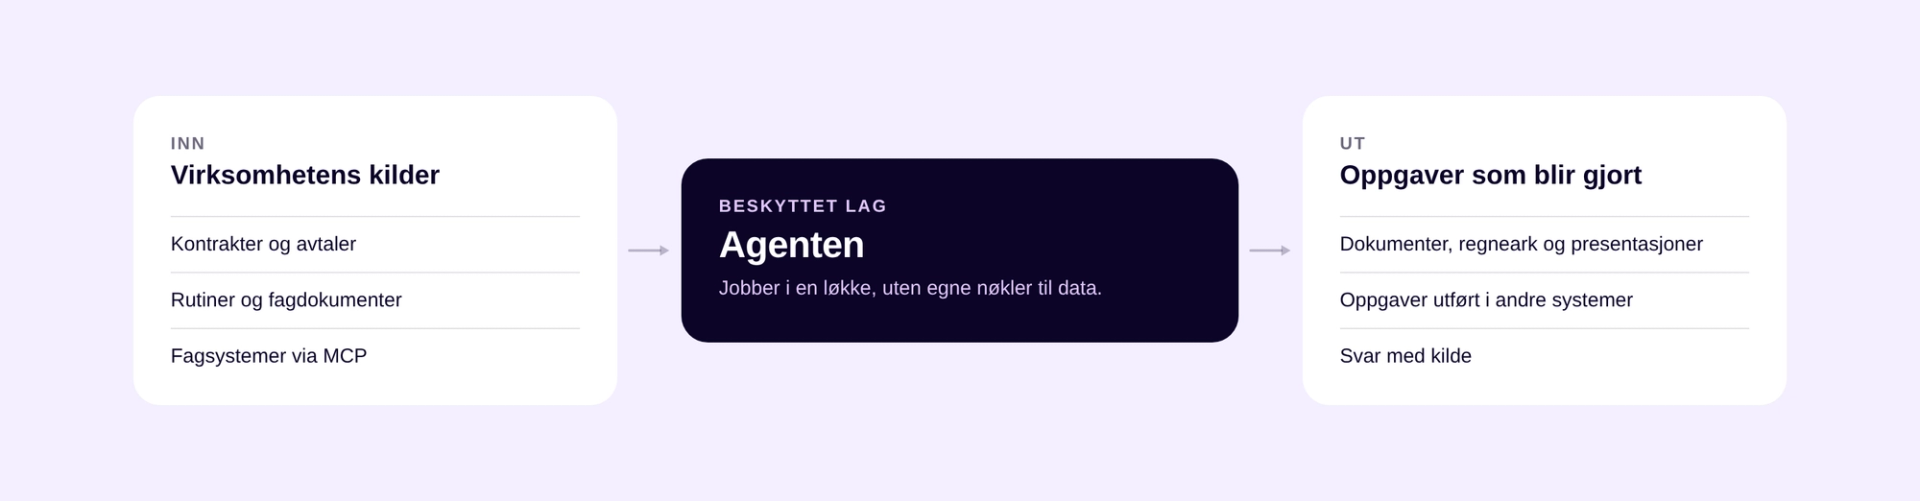
De fleste agentiske plattformene vi bygger for kundene våre, følger det samme mønsteret: Agenten leser virksomhetens dokumenter og data og svarer med kilde. Den bruker fagsystemene, lager utkast og filer, og løser oppgaver i flere steg før den leverer. Dataene den leser er ofte blant de mest sensitive virksomheten har, og derfor holder det ikke med en god modell når agenten skal i produksjon. Det som får en agent fra demo til trygg drift, er det vi bygger rundt modellen.
En chatbot svarer på spørsmål. En agent får en oppgave og jobber med den til den er ferdig. Den legger en plan, leser kilder, bruker verktøy, lager filer og sjekker arbeidet sitt før den svarer. Det gir mer verdi, men også høyere risiko. Agenten handler på vegne av en bruker, ofte i mange minutter av gangen, og den leser innhold som ingen har kvalitetssikret.
Før vi velger modell, stiller vi derfor tre spørsmål. Hva skal agenten få lov til å gjøre? Hva skal den få lov til å lese? Og hva skjer når noe går galt?

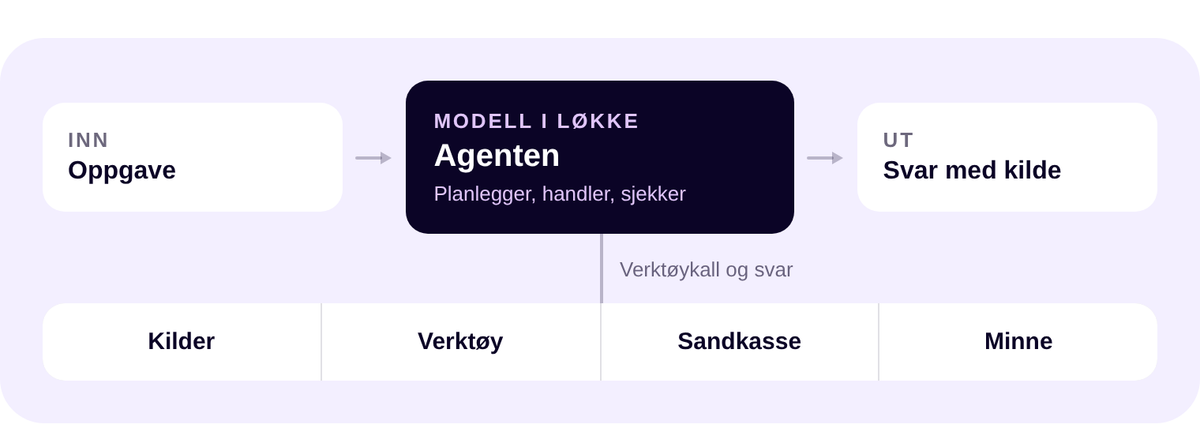
Agenten er en modell som jobber i en løkke. Alt den leser og gjør, går gjennom verktøy, og hvert kall sjekkes av appen.
Svarene på de tre spørsmålene handler sjelden om modellen. Modellene blir bedre og billigere hvert år, og de blir bedre for alle. En agent som leverer, og en som bare imponerer i en demo, kan bruke samme modell. Forskjellen ligger i to ting: harnessen og dataene.
Harnessen er måten agenten jobber på: løkken, verktøyene, ferdighetene, kvalitetssjekkene og reglene for når et menneske skal inn. Anthropic beskriver Claude Agent SDK som nettopp dette, harnessen som driver Claude Code, gjort tilgjengelig for andre agenter. Dataene er alt agenten vet: kildene, wikien, konteksten per kunde og prosjekt, og hvem som har tilgang til hva.
Hva agenten får gjøre, bestemmes av harnessen. Hva den får lese, bestemmes av dataene. Hva som skjer når noe går galt, bestemmes av arkitekturen og sikkerheten rundt.

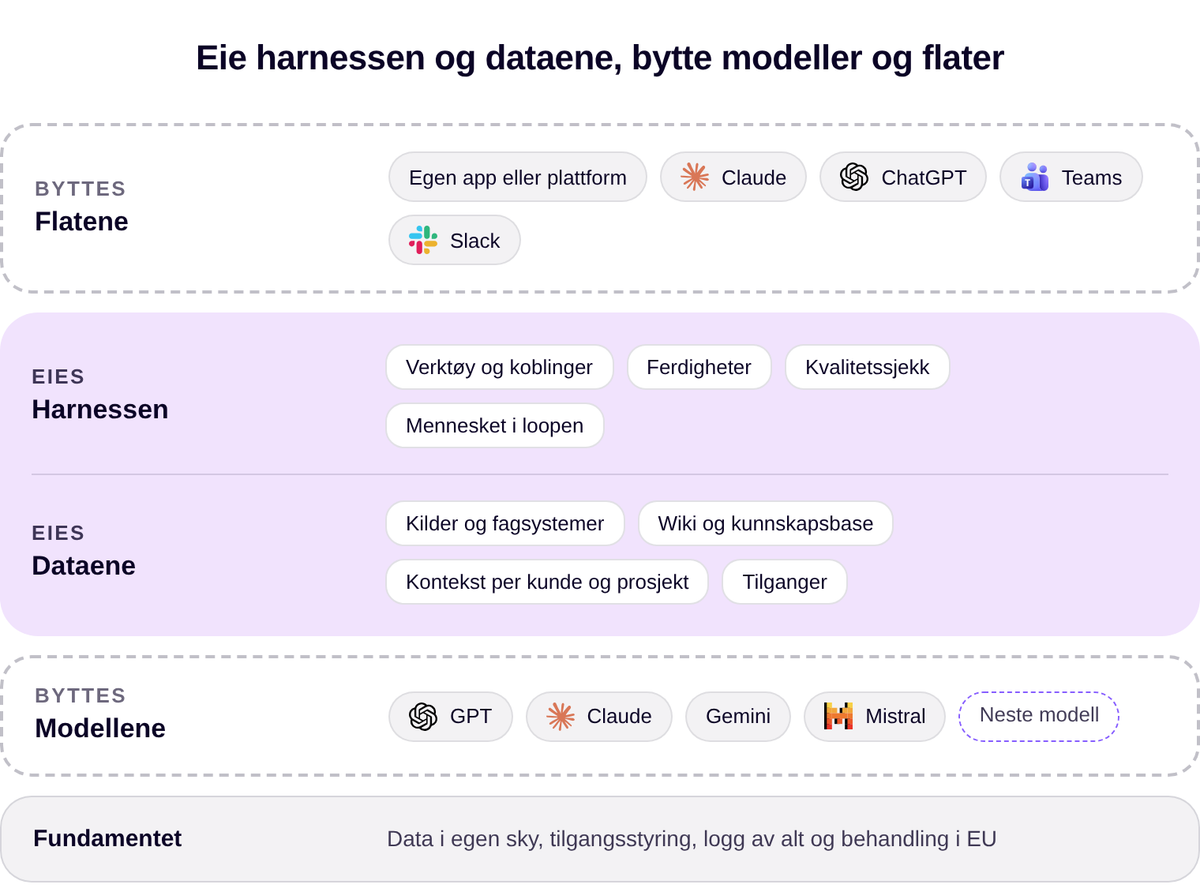
Modellene og flatene skifter hvert år. Harnessen og dataene er det som bygger verdi over tid.
Harnessen bygger vi i et agentrammeverk. Hvilket avhenger av oppgaven og hvor kunden har plattformen sin.
Skal agenten jobbe tett på filer, data og kode, velger vi ofte Claude Agent SDK. Dette er den samme harnessen som driver Claude Code.
Trenger vi holdbare kjøringer i kundens egen sky, bruker vi gjerne eve. Det er Vercels åpne rammeverk, der hver samtale kjører som en arbeidsflyt med PostgreSQL under. eve bygger på AI SDK, som vi også bruker alene til enklere agenter.
Har kunden et .NET-team, eller vil kunden holde seg i Microsoft-sporet med Foundry, er Microsoft Agent Framework et naturlig valg. Det slår sammen Semantic Kernel og AutoGen. Er GPT hovedmodellen, bruker vi OpenAI Agents SDK, som har sandkasse, filverktøy og ferdigheter på samme måte som Claude Agent SDK.
Felles for alle er at verktøyene, ferdighetene og dataene er våre egne, og ligger utenfor rammeverket. Da kan vi bytte rammeverk uten å bygge kunnskapen på nytt.
Modellen velges per steg, og hver kjøring har harde grenser på antall steg, tid og kommandoer. Da blir en agent som går seg vill aldri en stor regning.
En agent kan ikke mer enn verktøyene den får. Hos oss får den typisk fra en håndfull til et tjuetall verktøy, hver til én jobb. De som leser, ser kildene som en skrivebeskyttet mappestruktur. De som skriver, går alltid via appen, som kontrollerer tilgangen før noe blir lagret. Vil agenten endre en kontrakt, blir det et forslag som et menneske må godta.

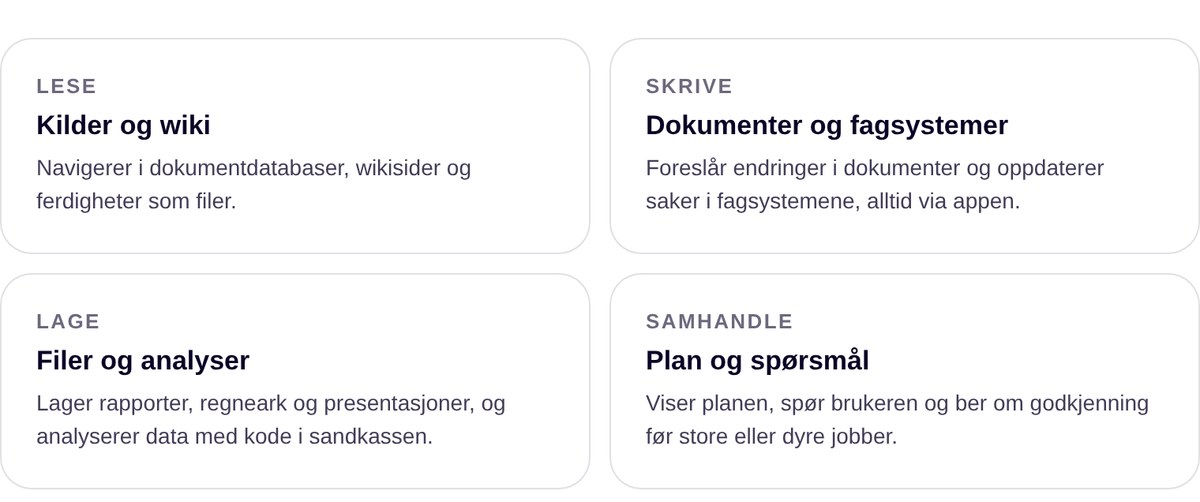
Verktøykassen i fire grupper. Ofte har agenten også en underagent som undersøker kildene på egen hånd, med bare lesetilgang.
Ferdigheter følger den åpne Agent Skills-standarden, som Anthropic utviklet og som nå brukes av mange agentprodukter. En ferdighet er en mappe med en SKILL.md som har navn og beskrivelse, og eventuelt skript, maler og referanser. Agenten ser bare navn og beskrivelse, og leser resten når den trenger ferdigheten. Slik kan virksomhetens maler, metodikk og skrivestil ligge klare uten å fylle opp konteksten. Formatet er åpent, så ferdighetene kan brukes på tvers av rammeverk.
Eksterne systemer kobles til med Model Context Protocol (MCP). Typiske koblinger er Microsoft 365, dokumentarkivet og bransjens egne fagsystemer. Brukeren logger inn med OAuth, og tokenet blir kryptert før det lagres. Arbeideren henter tokenet først når verktøyet kalles, så modellen ser det aldri. Administratorer kan skru av enkeltverktøy per kobling.
Hva agenten får lov til å lese, bestemmes av dataene den har tilgang til og hvordan den finner fram i dem. Vi starter ofte uten embeddings og vektordatabase. Når et dokument lastes opp, leser en modell det én gang og skriver wikisider om dokumentet, aktørene og temaene, med fakta og henvisninger. Agenten finner fram i wikien og kildene med grep, glob og read_file, på samme måte som en utvikler leter i en kodebase.
Anthropic anbefaler samme rekkefølge: start med agentisk søk, og legg til semantisk søk når hastighet eller variasjon i spørsmålene krever det. Spør brukerne etter en bestemt part, dato eller klausul, treffer et presist søk ofte bedre enn tekst som bare ligner. Blir datamengden stor, legger vi til vektorsøk med re-ranking i samme database. Det er det samme mønsteret vi beskriver i artikkelen om den agentiske hjernen.
Det siste spørsmålet, hva som skjer når noe går galt, svarer vi på med arkitekturen. Agenten kjører i et eget lag uten egne tilganger, og alt den leser og skriver, går gjennom appen. Blir agenten lurt, har den fortsatt ikke nøkkelen til noe.

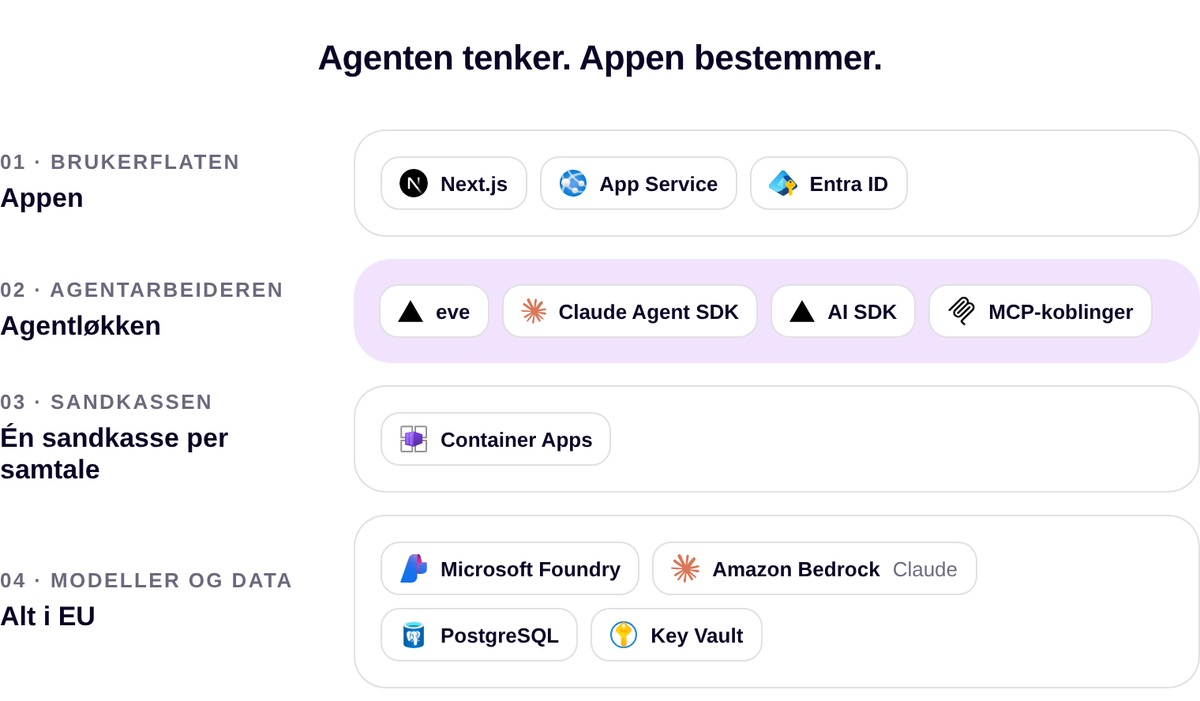
Agenten kjører i sitt eget lag og må spørre appen hver gang den skal lese eller skrive noe.
Øverst ligger appen der folk jobber, og den eier alle data og alle tilganger. Under den kjører agentarbeideren selve løkken, med holdbare kjøringer i PostgreSQL. Hver samtale får sin egen sandkasse, et isolert miljø der agenten kan kjøre kode og lage filer. Nederst ligger modellene i Microsoft Foundry og Amazon Bedrock i EU, og dataene bak private endepunkter.
Sikkerhet i en agentisk plattform handler om å anta at modellen før eller siden gjør noe dumt. Den kan misforstå, den kan bli lurt av en tekst i et dokument, og den kan prøve noe ingen har tenkt på. Vi bygger derfor flere lag rundt agenten, slik at ett lag som svikter ikke er nok til å gjøre skade.

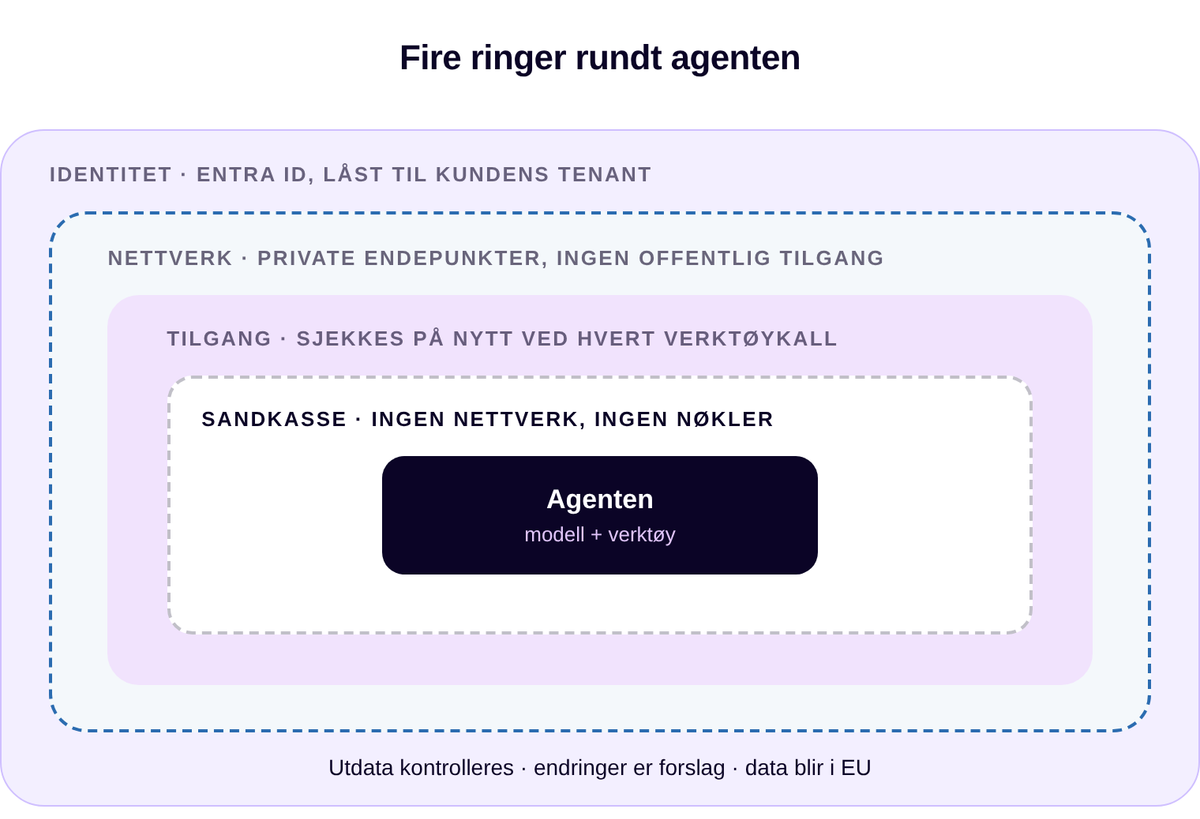
Hvert lag er laget for å holde selv om laget innenfor svikter.
Modellene kjører i EU, dataene brukes ikke til trening, og filer agenten lager kontrolleres før brukeren får dem.
Plattformen kjører typisk i kundens Azure, med Claude-modellene i Amazon Bedrock. Vi velger tjenester der kunden eier dataene, og der vi kan bytte modell, rammeverk og flate uten å bygge om resten.

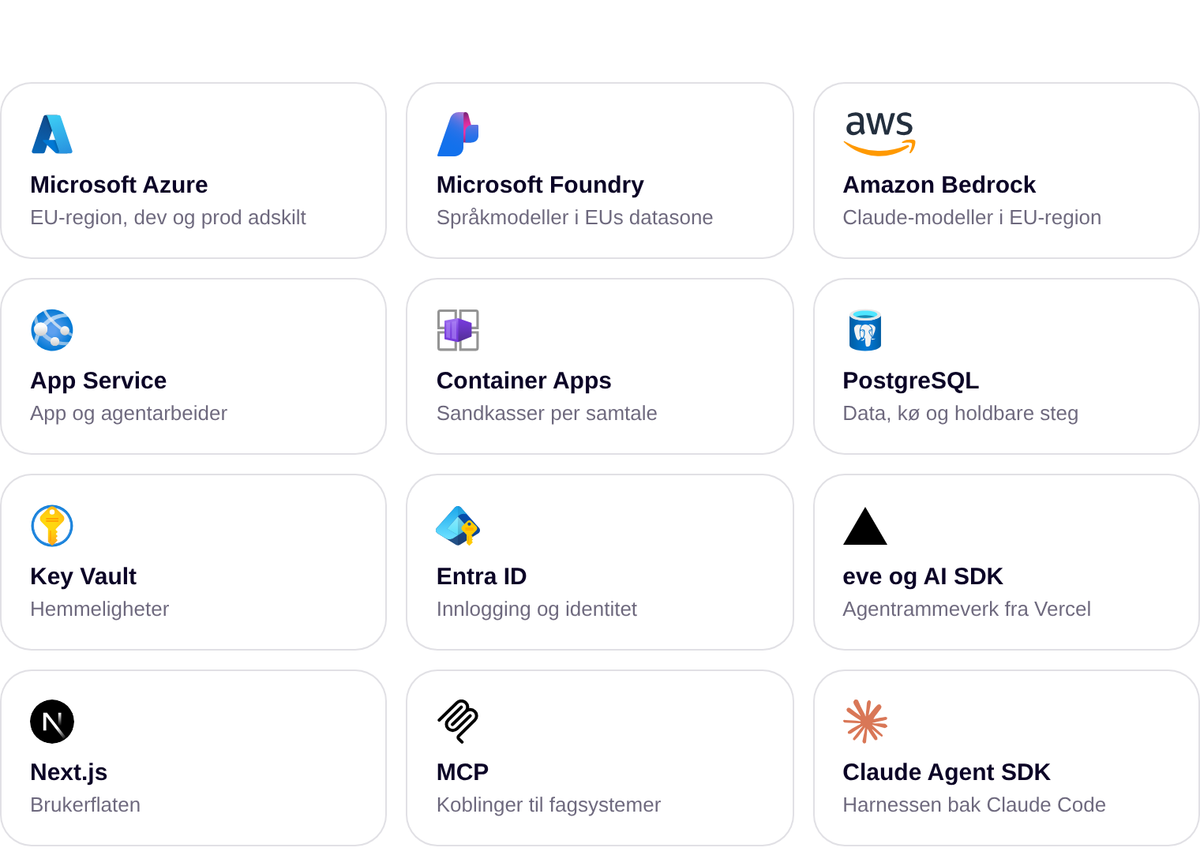
Plattformen er bygget for flere modell-leverandører og rammeverk. Vi bruker Microsoft Foundry og Amazon Bedrock, og velger modeller som kjører innenfor EU.
Ingen plattformer er like, men noen regler følger med fra prosjekt til prosjekt:
Neste nivå etter at dere har skapt en dataplattform er AI-agenter som går gjennom hele datagrunnlaget, bygger en intern wiki for virksomheten og holder den oppdatert selv.
Send en mail til arne@frend.no eller ring 942 47 197, så tar vi en prat om hva agenten skal gjøre, hvilke data den skal jobbe med og hvordan den skal sikres. Du kan også lese mer om hvordan vi jobber med data.
Vi gleder oss til å høre fra deg!


Har gått hele veien fra student til leder for data- og AI-teamet i Frend på 3 år. Er helt rå på Claude Agent SDK, Azure AI Foundry og Snowflake, og jobber med rådgivning og utvikling av skreddersydde data- og AI-plattformer.
Ring en Frend, eller fyll ut kontaktskjema. Vi gleder oss til å høre fra deg!

Arne Berg
Team- og fagleder data og AI
Henrik Ruud
Strategisk leder og rådgiver
Lora Temelkova
Leder for AI, app og automasjon